新零售 "无法阻挡"还是"无能为力"?——数据处理服务的视角
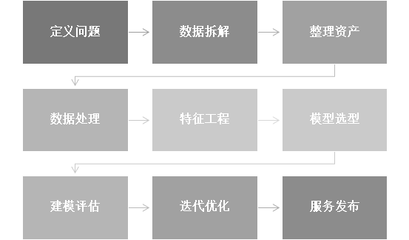
自2016年马云提出“新零售”概念以来,这场以数据驱动、线上线下融合为核心的商业变革迅速席卷各行各业。有人视其为“无法阻挡”的趋势,有人却在实际运营中感到“无能为力”。本文将从数据处理服务的专业视角出发,探讨新零售的真实境遇与关键瓶颈。
一、无法阻挡:数据是新零售的引擎
新零售的本质是数据驱动的泛零售形态。从消费者画像、智能选品、库存优化到精准营销,每一个环节都依赖高效的数据处理服务:
- 实时感知:通过IoT设备、POS系统、移动端埋点,实现全渠道数据采集;
- 数据中台:打破部门孤岛,统一用户ID、商品ID、订单ID,构建核心数据资产;
- 智能决策:利用机器学习预测销量、优化供应链,实现“千人千面”的个性化推荐。
在这种背景下,新零售呈现出“无法阻挡”的势头。那些率先完成数据化转型的企业,如盒马鲜生、瑞幸咖啡等,在效率和体验上实现了显著超越。数据成为新的生产资料,而数据处理服务则是挖掘这一生产资料的关键工具。
二、无能为力:数据处理的三重困境
更多传统零售企业在转型中遭遇了“无能为力”的窘境。原因并非缺乏意愿,而是数据处理能力跟不上业务需求:
1. 数据孤岛严重,整合成本高
很多企业线上有电商数据、线下有POS数据、还有微信、支付宝等第三方数据,彼此割裂。数据清洗、打通、归一化的工作量巨大,往往需要专门的数据治理团队和长时间迭代。
2. 实时性不足,决策滞后
新零售要求“即时满足”。但传统批处理模式(T+1)无法支撑实时补货、动态定价或秒级风控。即使采购了流计算平台,缺乏专业调优和数据管道建设经验,仍可能导致延迟高、丢数据、结果不可信。
3. 数据质量差,分析结果不可用
源头数据缺失、重复、口径不一致,导致报表自相矛盾。许多企业陷入了“垃圾进、垃圾出”的恶性循环,最终对数据驱动失去信心。
4. 成本与人才的双重压力
搭建一套可靠的数据处理服务(采集、存储、计算、治理、可视化)需要不小的软硬件投入和专业人才。中小零售企业往往无力承担,只能选择“无能为力”地维持原状。
三、破局之道:从数据处理服务切入
要让新零售从“口号”走向“现实”,不能只讲商业概念,必须依靠扎实的数据处理服务。以下是几个关键行动方向:
- 顶层设计,小步快跑:不要期望一次性搭建完美的大数据平台。从一个业务场景(如缺货预警)入手,快速验证数据处理链路,再逐步扩展。
- 拥抱云原生与Serverless:利用云厂商提供的数据集成、实时计算、数据湖等PaaS服务,降低运维成本,弹性伸缩应对大促流量。
- 建立数据治理规范:从一开始就定义好主数据、编码规则、质量校验规则,避免后期返工。可借助开源工具(如Apache Griffin、Atlas)辅助。
- 内外结合的人才策略:核心数据架构和算法可以聘请专家,数据接入和报表开发可培训内部IT/运营人员掌握低代码工具。
- 选择成熟的数据处理服务商:对于自身能力不足的企业,与专业的零售数据服务商合作,比自己从零研究更高效、更经济。
四、结论:不是“能不能”,而是“怎么做”
新零售的浪潮确实“无法阻挡”,因为它符合消费升级和技术演进的大方向。但对待每一家具体的企业,它也可能“无能为力”——如果你缺少合格的数据处理服务,数据就从资产变成了负担。
未来属于那些会用好数据的企业。新零售不是魔法,而是建立在采集、传输、存储、计算、治理这一整套数据处理服务之上的工程系统。想清楚你是要自己建团队、还是借力云和生态伙伴,然后脚踏实地从第一个数据管道开始,才是把“无能为力”变成“有力可为”的唯一路径。
如若转载,请注明出处:http://www.mangyouwei.com/product/52.html
更新时间:2026-10-07 03:21:04